Pernah menekan tombol jalankan SQL, lalu menatap layar menunggu hasil yang tak kunjung datang? Saat itulah Anda butuh membaca rencana eksekusi query. Dengan memahami query plan, Anda bisa mengetahui apa yang sebenarnya dilakukan mesin database, dari cara tabel dipindai hingga algoritma join yang dipilih, lalu mengambil keputusan optimasi yang tepat.
Apa itu Rencana Eksekusi Query?
Rencana eksekusi query adalah “peta jalan” yang dibuat optimizer untuk mengeksekusi perintah SQL Anda seefisien mungkin. Optimizer menimbang banyak strategi fisik—scan, join, sort—berdasarkan statistik, biaya (cost), serta estimasi baris (cardinality).
Plan menjabarkan urutan operasi, sumber data, penggunaan indeks, hingga estimasi biaya komputasi dan I/O. Di banyak DBMS modern, Anda juga dapat melihat waktu aktual eksekusi tiap langkah (dengan ANALYZE), sehingga bisa membandingkan prediksi dengan kenyataan.
Istilah kunci pada plan
- Cost: Perkiraan “biaya” relatif untuk menjalankan node plan; semakin kecil biasanya semakin baik.
- Rows/Cardinality: Estimasi jumlah baris yang diproses atau dihasilkan.
- Width: Perkiraan ukuran baris (byte), memengaruhi I/O dan memori.
- Actual time: Waktu eksekusi nyata per node (tersedia saat ANALYZE).
- Loops: Berapa kali node dijalankan (sering muncul pada nested loop).
Cara Membaca EXPLAIN di PostgreSQL dan MySQL
Membaca plan dimulai dari node teratas (root), lalu telusuri anak-anaknya hingga level terendah. Perhatikan apa yang terjadi pada setiap langkah: apakah ada sequential scan besar, apakah sort dilakukan di memori atau disk, dan bagaimana tabel-tabel di-join.
PostgreSQL
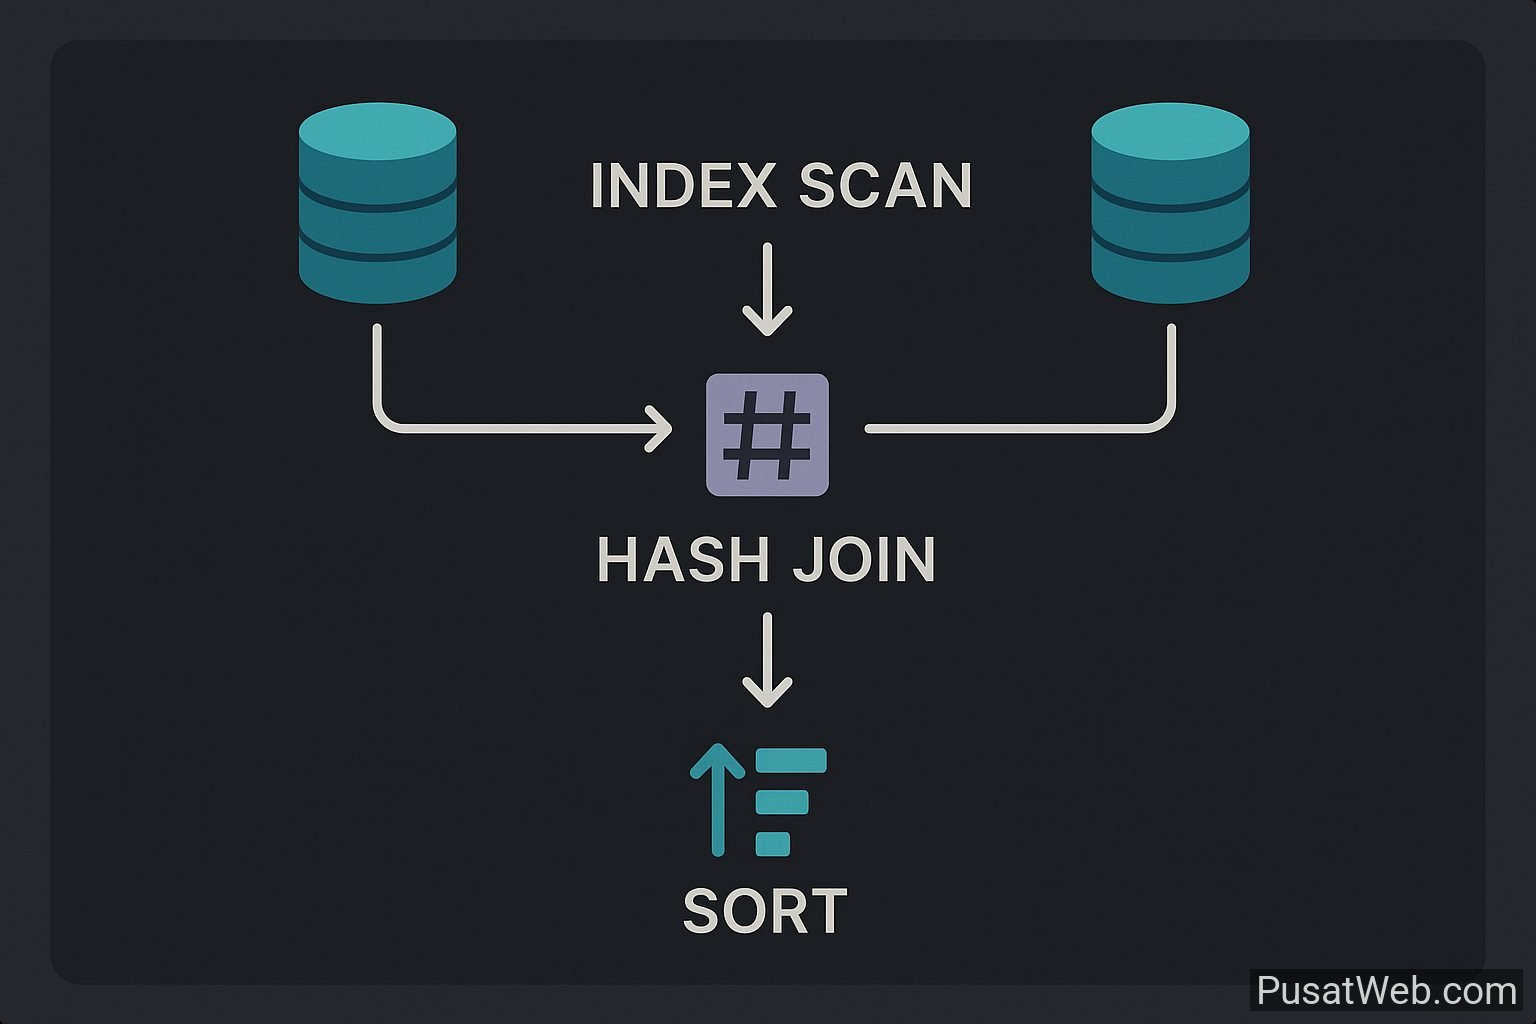
Gunakan EXPLAIN untuk melihat perkiraan, dan EXPLAIN (ANALYZE, BUFFERS) untuk waktu aktual dan statistik buffer. Node umum: Seq Scan (pindai penuh tabel), Index Scan, Bitmap Index/Heap Scan, serta algoritma join seperti Nested Loop, Hash Join, dan Merge Join.
PostgreSQL menampilkan cost dalam format startup..total dan estimasi rows. Perbedaan besar antara rows estimasi dan rows aktual sering menandakan masalah statistik, yang bisa membuat optimizer memilih strategi kurang optimal.
MySQL
Di MySQL, EXPLAIN menampilkan kolom seperti type (ALL, index, range, ref, eq_ref), possible_keys, key (indeks yang dipakai), rows (estimasi baris dibaca), dan filtered. type=ALL menandakan full table scan.
Gunakan EXPLAIN FORMAT=JSON untuk detail plan yang lebih kaya, atau EXPLAIN ANALYZE (MySQL 8.0.18+) guna melihat timing aktual. Periksa apakah indeks yang diharapkan benar-benar digunakan, dan seberapa selektif filter Anda.
Mengidentifikasi Bottleneck: Scan, Sort, Join
Plan membantu mengungkap hambatan performa. Fokuslah pada node yang memindai data besar, melakukan sort berat, atau join dengan biaya tinggi.
Tanda-tanda plan bermasalah
- Sequential scan besar pada tabel jutaan baris untuk filter selektif. Biasanya akibat missing index atau fungsi pada kolom terindeks (menghalangi penggunaan indeks).
- Sort/Filesort yang mendorong spill to disk. Tanda memori kerja tidak cukup atau ORDER BY tidak didukung indeks.
- Join tidak tepat (mis. Nested Loop pada set besar) atau urutan join yang buruk, sering dipicu estimasi cardinality keliru.
- Cardinality error: rows estimasi jauh dari aktual. Sering terjadi jika statistik kedaluwarsa, distribusi data skewed, atau ada predikat kompleks.
- Implicit cast dan ketidakcocokan tipe data (mis. membandingkan INT dengan VARCHAR) yang membuat indeks diabaikan.
- Wildcard di depan pada LIKE (‘%term’), OR berantai, atau ekspresi non-sargable yang memaksa scan penuh.
Strategi Optimasi Berdasarkan Rencana Eksekusi
Perbaikan terbaik bergantung pada apa yang plan tunjukkan. Prinsipnya: kurangi data lebih awal, gunakan indeks yang tepat, dan bantu optimizer dengan statistik akurat.
Desain dan penyesuaian indeks
- Tambahkan indeks selektif pada kolom filter dan join kunci. Untuk kueri multi-kolom, gunakan composite index dengan urutan sesuai selektivitas dan predikat.
- Covering index (kolom yang dipilih ada di indeks) dapat memangkas akses ke tabel. Di beberapa DBMS, fitur INCLUDE membantu.
- Prefix/functional index bila Anda sering memfilter dengan fungsi atau pola tertentu (bergantung dukungan DBMS).
- Hapus indeks tak terpakai agar penulisan data tidak terbebani.
Rewrite query yang lebih efisien
- Ganti SELECT * dengan kolom spesifik untuk menurunkan width dan I/O.
- Ubah IN subquery menjadi EXISTS atau JOIN jika plan menunjukkan biaya tinggi.
- Push down filter sedini mungkin; hindari fungsi pada sisi kolom saat memfilter.
- Pastikan klausa ORDER BY sejalan dengan indeks agar sort bisa dihindari.
Statistik, konfigurasi, dan teknik lanjutan
- Perbarui statistik (ANALYZE) dan rawat tabel (VACUUM/OPTIMIZE) agar estimator akurat.
- Sesuaikan work_mem/sort_buffer agar operasi sort dan hash tidak sering ke disk.
- Untuk kueri besar, pertimbangkan batching, pagination, atau streaming hasil.
- Gunakan CTE dengan bijak; pada beberapa DBMS, materialization bisa membantu atau malah memperlambat—lihat plan untuk memastikannya.
- Optimizer hints (bila tersedia) sebaiknya opsi terakhir setelah perbaikan desain dan statistik.
Checklist cepat
- Jalankan EXPLAIN (ANALYZE) pada kueri target dan soroti node termahal.
- Bandingkan rows estimasi vs aktual; jika meleset jauh, perbarui statistik dan tinjau distribusi data.
- Pastikan indeks sesuai predikat WHERE dan JOIN; uji alternatif composite/covering index.
- Hilangkan sort yang tidak perlu dengan menyelaraskan ORDER BY dan indeks.
- Uji rewrite kueri dan ukur kembali; validasi dampak pada beban tulis.
Checklist dan Kesalahan Umum
Kesalahan berulang seringkali sederhana, tetapi berefek besar terhadap latensi dan throughput. Kenali pola ini agar tidak terpeleset dua kali.
- Over-indexing: Terlalu banyak indeks memperlambat INSERT/UPDATE dan memperbesar storage.
- Mengabaikan estimasi: Hanya melihat waktu total tanpa meninjau node per langkah membuat akar masalah luput.
- Uji tanpa beban realistis: Plan bisa berbeda pada ukuran data kecil vs produksi.
- Lupa validasi regresi: Setelah optimasi, jalankan kembali EXPLAIN (ANALYZE) untuk memastikan perbaikan nyata.
- Hard-hints permanen: Mengunci optimizer pada strategi tertentu dapat menjadi bumerang saat data tumbuh.
Kesimpulannya, rencana eksekusi query adalah kompas yang memandu Anda mengambil keputusan optimasi berbasis bukti. Dengan kebiasaan rutin membaca EXPLAIN, memperbarui statistik, merancang indeks yang tepat, serta menulis ulang kueri secara cermat, Anda bisa memangkas waktu eksekusi dari hitungan detik menjadi milidetik—secara konsisten dan terukur.

