Pernah mencari penyebab bug yang hanya muncul tengah malam dan hilang saat pagi? Di sinilah Observability pada Software Custom memainkan peran krusial. Dengan visibilitas menyeluruh atas perilaku aplikasi, Anda tak sekadar memantau angka, tetapi memahami “mengapa” sebuah gejala muncul—sehingga perbaikan lebih cepat, tepat, dan dapat diulang.
Artikel ini merangkum fondasi observabilitas modern: dari logging, metrics, hingga tracing terdistribusi. Kita juga membahas arsitektur referensi, praktik terbaik, dan checklist implementasi agar tim Anda bisa memulai tanpa tersesat dalam alat dan istilah teknis.
Mengapa Observability pada Software Custom Penting
Software yang dibangun khusus sering memiliki logika domain unik, integrasi beragam, dan pola beban yang tak mudah diprediksi. Observability membuat tim mampu menjawab pertanyaan tak terduga dengan data yang benar, bukan sekadar intuisi.
Dengan observabilitas yang baik, Anda bisa menurunkan waktu deteksi (MTTD), mempercepat pemulihan (MTTR), dan memperkecil dampak insiden pada pelanggan. Dampaknya terlihat pada stabilitas rilis, kepuasan pengguna, dan biaya operasional yang lebih terkendali.
Monitoring vs Observability
Monitoring menjawab “apa yang salah” melalui metrik dan alarm. Observability melangkah lebih jauh, menjawab “mengapa” dengan kemampuan menyelidik berdasarkan log, metrik, dan jejak eksekusi (trace). Keduanya saling melengkapi: monitoring untuk penjagaan, observability untuk investigasi mendalam.
- Monitoring: ambang batas CPU, error rate, uptime, SLO alert.
- Observability: korelasi log-trace, analisis akar masalah, kontekstualisasi perilaku layanan.
Pilar Observability: Logging, Metrics, Tracing
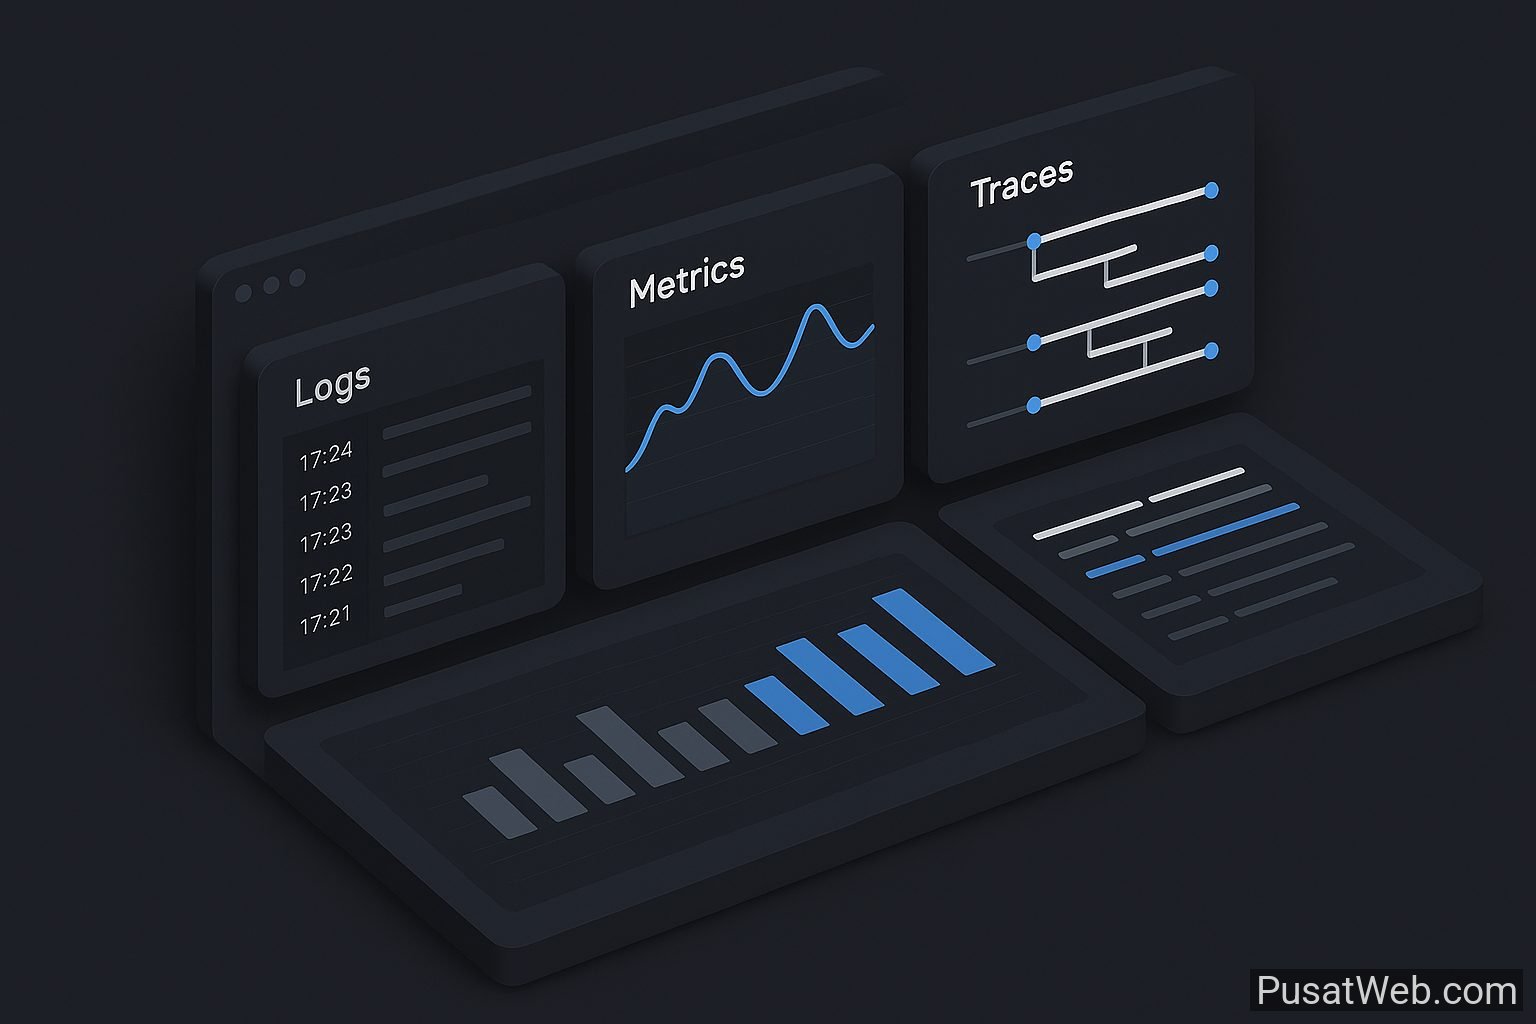
Tiga pilar ini menyediakan sudut pandang berbeda yang saling menguatkan. Gunakan bersama agar Anda bisa “memutar ulang” peristiwa secara forensik, dari sinyal global hingga detail permintaan individu.
Logging yang Bermakna
Log adalah narasi kejadian. Terapkan structured logging (JSON) agar mudah diolah dan difilter. Sertakan request ID atau correlation ID untuk mengaitkan log antar layanan, serta context domain (user_id, order_id) guna mempercepat investigasi.
- Gunakan level log yang konsisten (INFO, WARN, ERROR) dan hindari noise.
- Masking data sensitif (PII, token) di sisi aplikasi atau pada log pipeline.
- Definisikan retensi berbeda untuk log akses vs log aplikasi.
Metrics untuk Sinyal Global
Metrik adalah ringkasan numerik untuk tren dan alarm. Gunakan jenis yang tepat: counter untuk perhitungan kumulatif, gauge untuk nilai saat ini, dan histogram untuk distribusi latensi. Terapkan pola RED (Rate, Errors, Duration) untuk layanan pengguna, dan USE (Utilization, Saturation, Errors) untuk infrastruktur.
- Tentukan SLI/SLO yang relevan dengan pengalaman pengguna (misalnya p95 latensi checkout).
- Hindari cardinality tinggi pada label metrik (misal label per user) demi efisiensi biaya.
- Gunakan recording rules untuk agregasi yang sering dipakai di dasbor dan alarm.
Tracing Terdistribusi
Distributed tracing merekam perjalanan permintaan lintas layanan sebagai rangkaian span. Ini mempermudah mengisolasi lambatnya dependensi, hot path, dan anomali. Standar seperti OpenTelemetry memudahkan instrumentasi lintas bahasa dan platform.
- Propagasikan trace context melalui header (misal W3C traceparent).
- Gunakan sampling cerdas (tail-based) agar biaya tetap terkendali tanpa hilang kasus penting.
- Kaitkan span dengan log (via trace_id) untuk korelasi dua arah.
Desain Arsitektur Observability untuk Sistem Kustom
Mulailah dari instrumentation di aplikasi. Gunakan SDK/agent untuk mengirim log, metrik, dan trace ke collector terpusat. Dari sini, data dialirkan ke penyimpanan dan backend analitik (misal time-series DB untuk metrik, indeks pencarian untuk log, dan penyimpanan trace).
Pipa Data dan Integrasi
Rancang pipeline yang tahan gangguan: buffering ketika terjadi lonjakan, retry dengan backoff, dan circuit breaker agar aplikasi tidak terganggu saat backend observabilitas bermasalah. Pisahkan lingkungan (dev/staging/production) agar analisis tidak tercampur.
- Standarisasi skema: kunci log, nama metrik, dan atribut span konsisten.
- Gunakan tagging level layanan (service, version, region) untuk filter cepat.
- Siapkan jalur SIEM terpisah untuk log keamanan dan kepatuhan.
Kontrol Biaya dan Skala
Biaya sering membengkak karena cardinality dan volume berlebih. Terapkan sampling adaptif untuk trace, drop log debug di produksi, dan batasi label metrik yang berdimensi besar. Gunakan retensi berjenjang: data granular pendek umur, agregat bertahan lebih lama.
- Prioritaskan perjalanan pengguna kritis untuk full fidelity tracing.
- Gunakan exemplars untuk menghubungkan outlier metrik ke trace spesifik.
- Otomatiskan rollover indeks log dan kompresi penyimpanan.
Keamanan & Privasi
Jangan jadikan observabilitas sebagai jalur kebocoran data. Terapkan PII scrubbing, tokenisasi, dan role-based access control untuk dasbor. Audit akses ke data sensitif dan lacak perubahan konfigurasi.
- Whitelist atribut yang boleh diekspor dari aplikasi.
- Enkripsi in transit dan at rest untuk log dan trace.
- Uji redaction secara berkala dengan kasus uji yang memuat data tiruan.
Alerting & Operasional
Bangun rantai alarm yang relevan dan dapat ditindaklanjuti. Hindari alert fatigue dengan deduplication, grouping, dan ambang berbasis SLO. Sediakan runbook terautomasikan untuk respons insiden.
- Gunakan routing berdasarkan layanan dan jam kerja/on-call.
- Tambahkan tautan cepat ke dasbor, trace, dan log terkait pada notifikasi.
- Review alarm setiap retro insiden untuk memangkas kebisingan.
Praktik Terbaik dan Checklist Implementasi
Jadikan observabilitas sebagai kemampuan tim, bukan proyek sekali jalan. Berikut langkah praktis untuk memulai dan meningkatkan maturitas secara bertahap.
- Tetapkan tujuan bisnis: turunkan ke SLI/SLO (mis. p95 latensi pembayaran ≤ X ms, error rate ≤ Y%).
- Petakan alur pengguna kritis (checkout, onboarding, sinkron data) dan instrumentasi end-to-end.
- Pilih standar: gunakan OpenTelemetry untuk konsistensi lintas bahasa.
- Definisikan konvensi: penamaan layanan, label metrik, kunci log, dan penyebaran correlation ID.
- Bangun pipeline: kolektor, penyimpanan, retensi, serta backup rencana darurat.
- Buat dasbor per audiens: bisnis (SLO), operasi (golden signals), pengembang (tracing detail).
- Siapkan alerting: berbasis SLO, anti-flapping, disertai runbook otomatis.
- Uji di staging: simulasi beban, suntik fault, cek keterlacakan dan akurasi alarm.
- Rilis bertahap: aktifkan instrumentasi secara progressive untuk layanan prioritas.
- Review berkala: post-incident review, audit biaya, dan penyempurnaan skema data.
Terakhir, latih tim membaca sinyal dengan perspektif domain. Observabilitas yang efektif menggabungkan alat yang tepat dengan kebiasaan investigasi yang tajam dan kolaborasi lintas fungsi.
Kesimpulan
Observabilitas yang matang mengubah reaksi panik saat insiden menjadi disiplin pemulihan yang sistematis. Dengan pilar log, metrik, dan trace yang dirancang baik, arsitektur pengumpulan data yang andal, serta praktik penerapan yang disiplin, software custom Anda akan lebih tangguh menghadapi ketidakpastian. Mulailah dari alur terpenting, ukur yang berdampak pada pengguna, dan biarkan data membimbing keputusan teknis Anda.