Bagaimana jika Anda bisa melatih model AI di jutaan perangkat tanpa satu byte pun data mentah meninggalkan perangkat tersebut? Itulah janji Federated Learning: pendekatan pelatihan kolaboratif yang menjaga privasi, mengurangi risiko kebocoran, dan tetap menghasilkan model yang andal.
Apa itu Federated Learning dan Mengapa Penting?
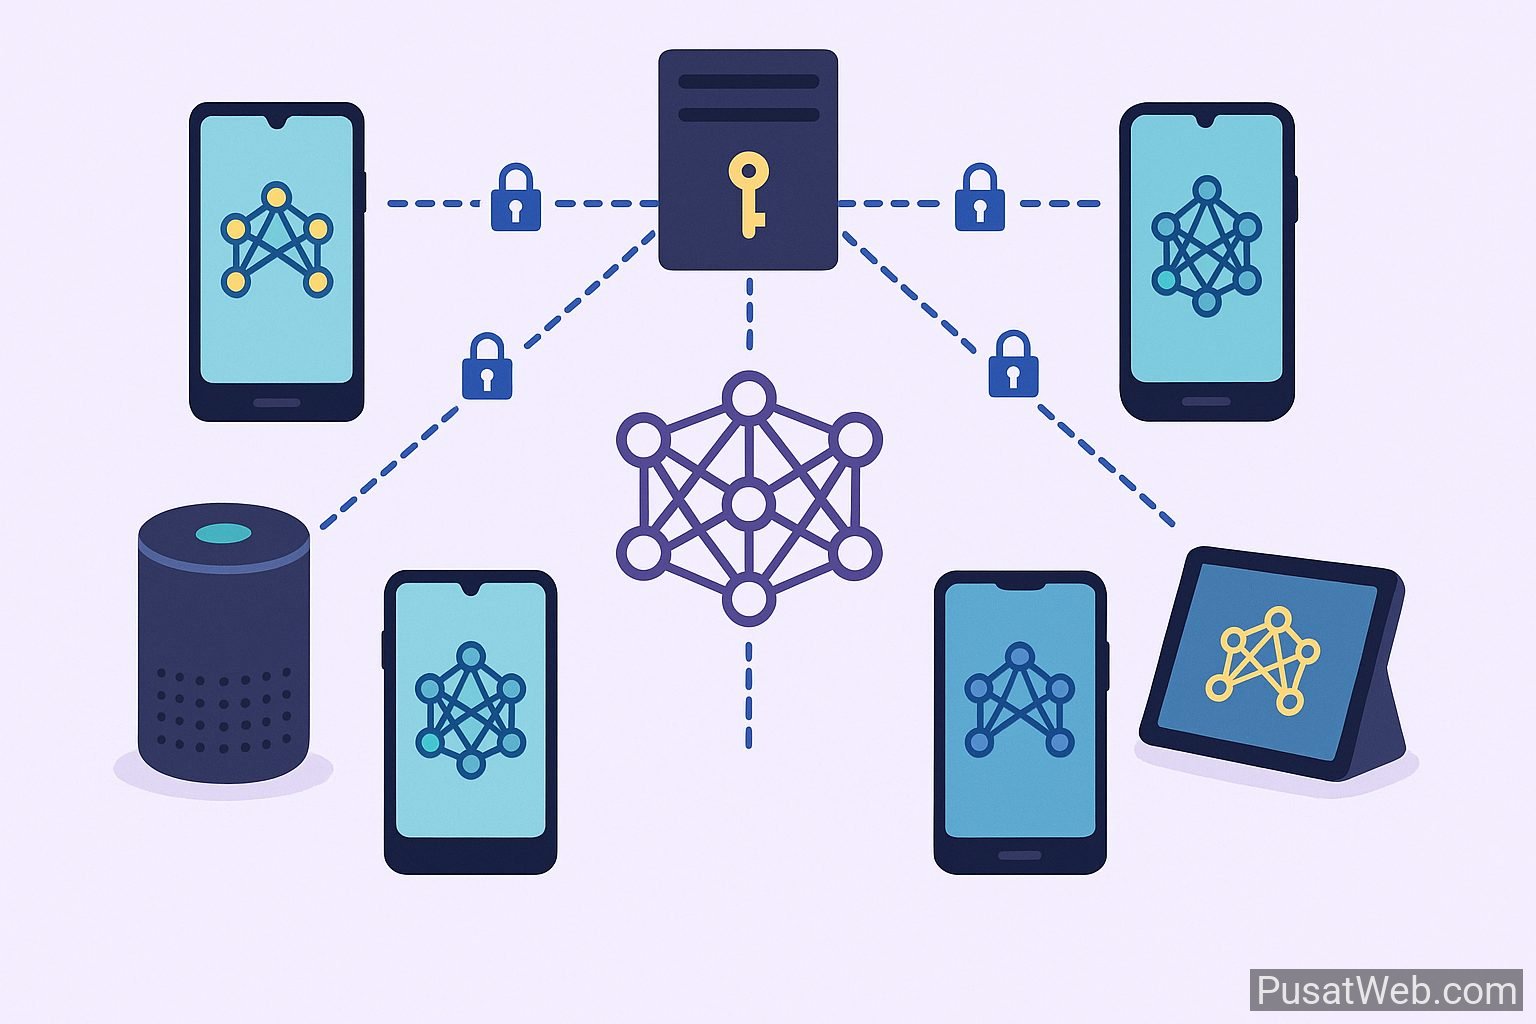
Federated Learning (pembelajaran terfederasi) adalah metode melatih model secara terdistribusi di banyak klien—misalnya smartphone, endpoint IoT, atau server organisasi—lalu hanya mengirimkan pembaruan parameter (gradien atau bobot) ke server pusat untuk digabungkan. Data mentah tetap berada di sumbernya.
Pendekatan ini menjawab kebutuhan lintas industri yang sensitif data: kesehatan, keuangan, dan telekomunikasi. Selain mematuhi regulasi privasi, Federated Learning juga menekan biaya transfer data besar dan memanfaatkan komputasi on-device untuk peningkatan berkelanjutan.
Secara ringkas, Anda memperoleh manfaat pelatihan kolaboratif seperti jika data disatukan, namun tetap mempertahankan privasi data dan kepemilikan setempat.
Arsitektur & Mekanisme Utama Federated Learning
Peran Server dan Klien
Arsitektur umum terdiri dari coordinator (server) dan banyak klien. Server mendistribusikan model global, mengumpulkan pembaruan, lalu melakukan agregasi untuk menghasilkan model baru. Klien melakukan pelatihan lokal menggunakan data masing-masing dalam beberapa epoch.
Algoritme Agregasi
Algoritme klasiknya adalah FedAvg (Federated Averaging), yang menggabungkan pembaruan klien berbobot proporsi ukuran data atau langkah pelatihannya. Untuk data yang tidak identik (non-IID) dan tidak seimbang, variasi seperti FedProx atau optimisasi adaptif (mis. Adam/Adagrad di sisi server) sering dipakai.
Seleksi Klien dan Ketahanan
Tidak semua klien aktif setiap saat. Mekanisme client sampling memilih subset perangkat yang online dan cukup bertenaga. Untuk menghadapi stragglers dan koneksi tidak stabil, sistem umumnya menetapkan batas waktu kontribusi, asynchronous aggregation, serta fault tolerance.
Efisiensi Komunikasi
Komunikasi sering menjadi hambatan. Teknik seperti model sparsification, kuantisasi bobot (8-bit atau lebih rendah), dan pengiriman delta terkompresi membantu memangkas jejak bandwidth dan mempercepat siklus pelatihan terdistribusi.
Menjaga Privasi: Differential Privacy dan Keamanan
Differential Privacy (DP)
Differential Privacy menambahkan “noise” terkontrol ke gradien atau metrik agar kontribusi tiap individu sukar ditelusuri. Pendekatan seperti DP-SGD memungkinkan pelatihan tetap akurat sembari membatasi kebocoran informasi. Penting untuk mengelola privacy budget (nilai epsilon) agar tidak terkuras selama banyak putaran federasi.
Secure Aggregation
Secure aggregation memastikan server hanya melihat hasil agregasi, bukan pembaruan klien secara perorangan. Dengan kriptografi (mis. secret sharing), kontribusi klien dienkripsi end-to-end dan baru dapat didekripsi setelah dijumlahkan. Ini melindungi dari pengintipan parameter parsial.
Lapisan Keamanan Tambahan
Enklave tepercaya (TEE), tanda tangan kode, serta verifikasi integritas mencegah manipulasi model di perangkat. Untuk skenario berisiko tinggi, enkripsi homomorfik parsial mulai dieksplorasi, meski biaya komputasinya masih tinggi.
Terakhir, audit dan logging anonim membantu compliance tanpa merekam data sensitif. Rate limiting dan deteksi anomali mengurangi ancaman poisoning dari klien berniat jahat.
Kapan Harus Menggunakan Federated Learning? Studi Kasus & Batasan
Use Case yang Tepat
- Kesehatan: rumah sakit melatih model deteksi penyakit di citra medis tanpa menyalin data pasien ke pusat.
- Perbankan: model anti-penipuan kolaboratif di beberapa bank, dengan data transaksi tetap di server masing-masing.
- Telekomunikasi: optimasi jaringan dan prediksi churn dengan memanfaatkan data operasional di lokasi.
- On-device AI: keyboard cerdas, personalisasi rekomendasi, dan speech model yang belajar dari penggunaan aktual pengguna.
Batasan Praktis
- Non-IID dan bias: perbedaan distribusi data antar klien bisa menurunkan konvergensi; diperlukan teknik personalisasi atau penyeimbangan.
- Overhead komunikasi: siklus federasi yang terlalu sering akan mahal; perlu kompromi antara frekuensi sinkronisasi dan kualitas model.
- Keandalan perangkat: baterai, konektivitas, dan kapasitas komputasi bervariasi; perlu kebijakan partisipasi dinamis.
- Evaluasi dan observabilitas: sulit menginspeksi performa per klien tanpa melanggar privasi; metrik agregat dan privacy-preserving analytics jadi kunci.
Jika data dapat dipusatkan dengan aman, pipeline biasa mungkin lebih sederhana. Namun ketika regulasi ketat atau data sangat terdistribusi, Federated Learning unggul secara strategis.
Langkah Implementasi dan Praktik Terbaik
1) Perumusan Masalah & Desain Data
Mulai dengan definisi objektif, metrik, dan batasan privasi. Standarkan skema fitur lintas klien (unit, normalisasi, feature store) agar model menerima sinyal konsisten meski data heterogen.
2) Pilih Kerangka Kerja
Manfaatkan framework seperti Flower, TensorFlow Federated, OpenFL, atau PySyft. Pastikan mendukung client sampling, secure aggregation, dan integrasi MLOps (versioning, experiment tracking, CI/CD model).
3) Kebijakan Privasi yang Terukur
Terapkan DP di level gradien atau output, lalu catat konsumsi privacy budget. Gabungkan dengan secure aggregation dan kebijakan akses minimal. Dokumentasikan bagaimana noise memengaruhi akurasi dan kapan perlu menambah data atau menyesuaikan hiperparameter.
4) Optimasi Komputasi & Komunikasi
Gunakan kuantisasi, sparsifikasi, dan pengiriman delta. Pertimbangkan partial model updates (mis. hanya lapisan atas) untuk menekan biaya. Atur jadwal federasi adaptif berdasarkan kondisi jaringan dan tingkat konvergensi.
5) Personalisasi dan Non-IID
Kombinasikan model global dengan lapisan atau head khusus klien untuk personalisasi. Teknik regularization (FedProx) dan meta-learning membantu stabilitas pada data tak seimbang.
6) Evaluasi, Uji, dan Rilis
Ukur performa pada holdout lokal yang tidak dibagikan. Gunakan shadow deployment dan A/B privacy-preserving dengan metrik agregat. Siapkan rollback cepat jika deteksi drift atau penurunan kualitas muncul.
7) Tata Kelola dan Kepatuhan
Bangun governance: perjanjian pemrosesan data, hak audit, dan model cards yang menjelaskan tujuan, keterbatasan, dan risiko. Selaraskan dengan regulasi (mis. GDPR, HIPAA setempat) dan kebijakan internal keamanan.
Pada akhirnya, Federated Learning bukan sekadar fitur teknis, melainkan strategi organisasi untuk mengekstrak nilai dari data terdistribusi tanpa mengorbankan kepercayaan dan privasi pengguna.
Kesimpulan: Federated Learning memungkinkan pelatihan kolaboratif lintas perangkat atau institusi dengan menjaga data tetap di tempat. Dengan kombinasi arsitektur yang tepat, secure aggregation, dan Differential Privacy, organisasi dapat meraih model yang akurat sekaligus patuh regulasi. Mulailah dari use case bernilai tinggi, pilih framework yang sesuai, dan bangun fondasi tata kelola yang kuat agar adopsi berkelanjutan.