Anggaran makin ketat, pengguna menuntut respons kilat, dan data makin sensitif. Di tengah tekanan ini, Small Language Models (SLM) muncul sebagai jalan tengah: performa cukup, biaya rendah, dan jejak komputasi ramping. Artikel ini merangkum cara memilih, mengoptimalkan, dan mengoperasionalkan SLM agar sistem AI Anda tetap lincah tanpa mengorbankan kualitas.
Mengapa Small Language Models Layak Dipertimbangkan
SLM adalah model bahasa berukuran kompak (puluhan hingga beberapa ratus juta parameter) yang dirancang untuk tugas terfokus. Alih-alih mencoba menguasai segalanya seperti LLM besar, SLM unggul di skenario sempit dengan konteks jelas dan batasan perangkat keras ketat.
Kapan SLM tepat digunakan
- Use case terdefinisi: ringkasan internal, ekstraksi entitas, klasifikasi tiket, auto-reply standar, atau analisis pola log.
- Batasan biaya: targetkan biaya per 1K token turun 3–10x dibanding LLM besar.
- Privasi & kepatuhan: jalankan on-prem atau on-device untuk menahan data sensitif di lingkungan Anda.
- Latensi rendah: aplikasi yang menuntut p95 di bawah 300 ms pada prompt pendek.
Kapan SLM kurang cocok
- Penalaran kompleks multi-langkah yang butuh pengetahuan luas dan kreativitas tinggi.
- Konten generatif panjang dengan gaya khusus dan variasi besar.
- Domain sangat dinamis tanpa data pelatihan/penyelarasan yang memadai.
Strategi praktis: gunakan SLM untuk 70–80% permintaan yang repetitif dan cepat, lalu rute sisanya ke LLM besar (smart routing). Dengan ini, Anda meraih keseimbangan biaya, kecepatan, dan kualitas.
Strategi Optimasi: Distilasi, Kuantisasi, dan LoRA
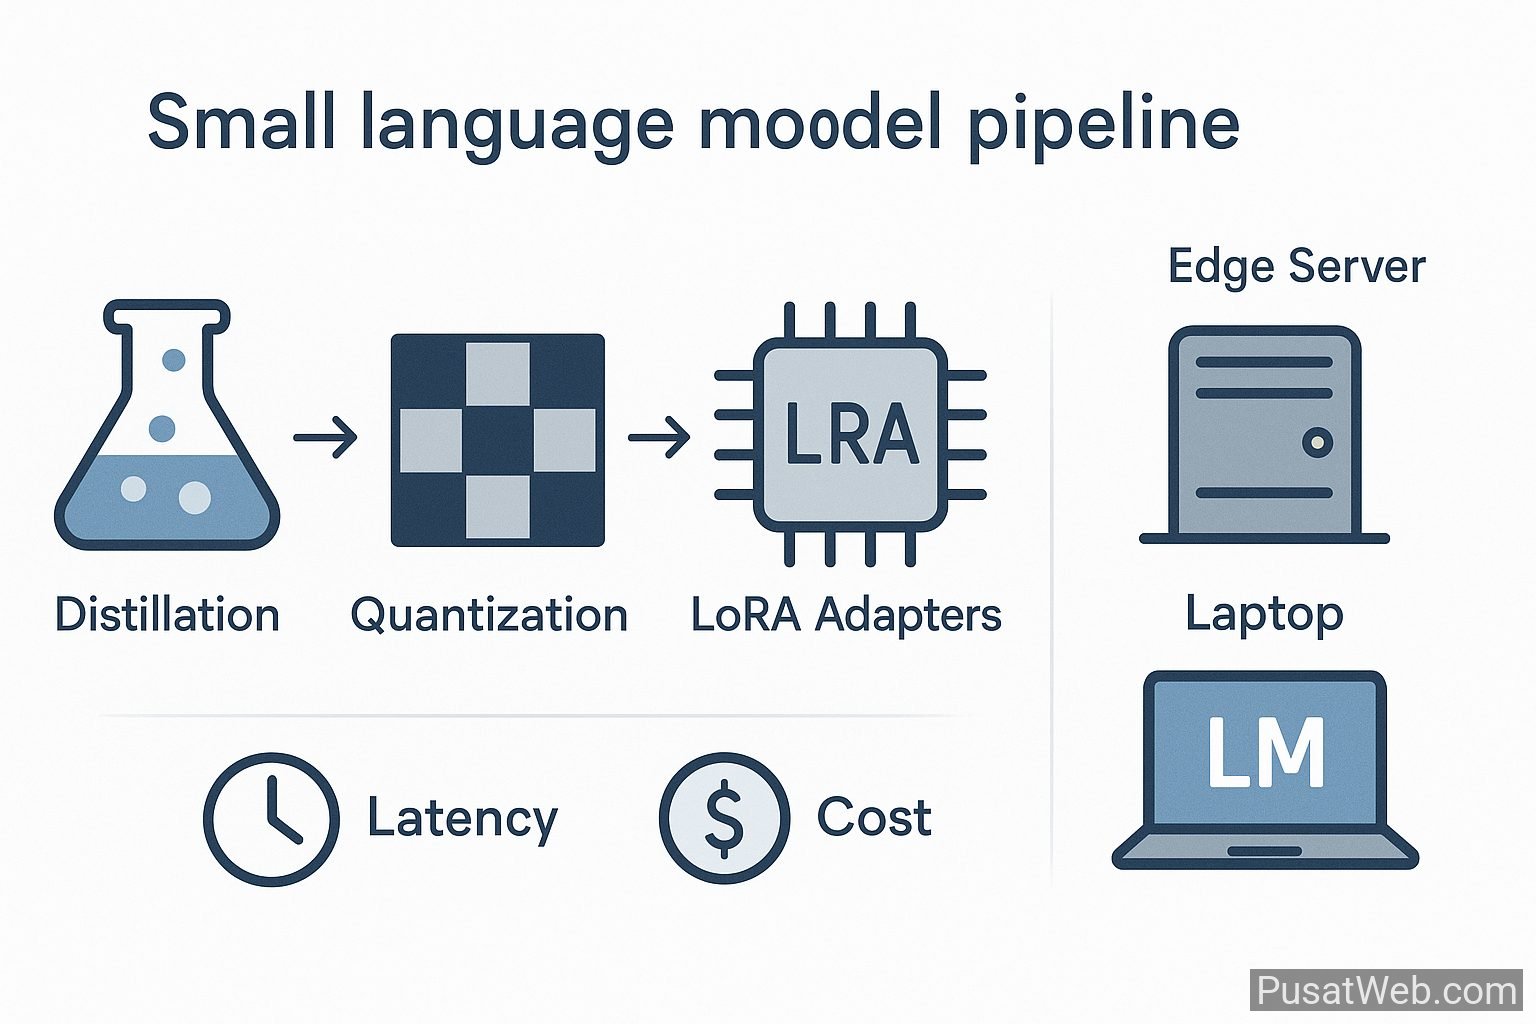
Mengubah model umum menjadi SLM andal untuk tugas Anda menuntut tiga pilar: distilasi, kuantisasi, dan fine-tuning parameter-efisien (LoRA/QLoRA). Kuncinya adalah kompromi terukur antar akurasi, latensi, dan jejak memori.
Distilasi pengetahuan
- Gagasan utama: model siswa (kecil) belajar meniru keluaran model guru (besar) di dataset tugas Anda.
- Sumber data: gabungan data historis, prompt sintetis, dan variasi terkontrol (parafrase, hard negatives).
- Tips: gunakan kurikulum—mulai dari contoh mudah ke sulit; ukur stabilitas dengan val-set yang merepresentasikan edge case.
Kuantisasi (int8/int4) yang aman kualitas
- Tujuan: memangkas memori dan mempercepat inferensi. Int8 sering aman untuk produksi; int4 memberi penghematan lebih namun butuh kalibrasi ketat.
- Metode populer: PTQ (post-training quantization) dengan kalibrasi representatif; AWQ/GPTQ untuk menjaga bobot penting.
- Waspada: cek degradasi pada metrik spesifik tugas, bukan hanya skor umum. Uji p95/p99 latensi karena kuantisasi bisa mengubah pola performa.
Fine-tuning hemat: LoRA/QLoRA
- LoRA menambah adaptor kecil pada lapisan tertentu sehingga Anda tak perlu melatih semua parameter.
- QLoRA menggabungkan kuantisasi + LoRA untuk training hemat GPU tanpa penurunan kualitas signifikan.
- Praktik: aktifkan early stopping ketat, batasi panjang output, dan gunakan regularisasi ringan agar model tak overfit pada gaya data pelatihan.
Tambahan yang kadang berguna: pruning terukur (pangkas neuron kurang penting) dan distilasi instruksi spesifik (instruction tuning) untuk memperhalus perilaku dialog.
Arsitektur Inferensi dan Biaya: Dari GPU ke CPU Modern
SLM memberi keleluasaan arsitektur: Anda tak selalu butuh GPU mahal. Dengan runtime efisien dan strategi batching, throughput bisa melonjak sementara biaya anjlok.
Pilihan runtime dan perangkat keras
- GPU kecil/menengah: cocok untuk beban serentak tinggi, manfaatkan batching dinamis dan KV-cache sharing.
- CPU modern: dengan kuantisasi int8/int4 dan kernel teroptimasi (mis. AVX512/AMX), banyak SLM bisa melayani ratusan RPS berbiaya rendah.
- Edge/on-device: untuk privasi maksimal dan latensi super rendah; pertimbangkan ukuran model di bawah 1–2 GB.
Optimasi jalur inferensi
- Speculative decoding: tebak cepat dengan model lebih kecil, verifikasi dengan model target untuk memangkas latensi.
- Streaming token: percepat TTFB agar UI terasa responsif meski total waktu render sama.
- Cache prompt/template: simpan embedding atau KV-cache untuk pola prompt berulang.
Skema penskalaan
- Autoscaling per antrian prioritas: pisahkan beban real-time dan batch.
- SLA-aware routing: rute permintaan besar/kompleks ke LLM berbeda, sisanya ke SLM.
- Observabilitas biaya: pantau cost per 1K token, latensi p50/p95, dan tingkat kegagalan untuk tiap varian model.
Hasil yang diincar: biaya turun signifikan, p95 stabil, dan pemanfaatan instans di atas 60–70% tanpa mengorbankan pengalaman pengguna.
Evaluasi, Keamanan, dan Kepatuhan
SLM yang cepat tapi salah arah tetap mahal. Pastikan evaluasi terukur dan kontrol risiko memadai, terutama bila data sensitif terlibat.
Evaluasi yang relevan tugas
- Bangun set uji internal: 200–1.000 contoh yang mencerminkan kasus nyata, termasuk edge case.
- Metrik: akurasi/precision-recall (klasifikasi), ROUGE/BERTScore (ringkasan), BLEU/ChrF (terjemahan singkat), dan human review terarah.
- Bandingkan alternatif: SLM baseline vs SLM + LoRA vs SLM + distilasi + kuantisasi untuk memetakan trade-off.
Keamanan dan etika
- Filter input/output: cegah kebocoran data, PII, dan konten berbahaya.
- Rate limiting & auth: hindari penyalahgunaan dan lonjakan biaya tak terduga.
- Bias & keadilan: uji ketidakberpihakan pada segmen pengguna yang berbeda.
Kepatuhan dan jejak audit
- Data lineage: rekam sumber data pelatihan/penyelarasan dan lisensinya.
- Model versioning: tag setiap rilis dengan hyperparameter, set uji, dan hasil evaluasi.
- Privasi: pertimbangkan differential privacy atau federated fine-tuning jika data sangat sensitif.
Dokumentasi yang rapi memudahkan audit, meminimalkan risiko hukum, dan mempercepat siklus rilis.
Peta Jalan Implementasi 90 Hari
Gunakan rencana ini sebagai kerangka kerja cepat menuju produksi.
Hari 0–30: Pembuktian nilai (PoV)
- Definisikan 1–2 use case sempit dengan KPI jelas: p95 latensi, akurasi tugas, dan biaya per 1K token.
- Pilih SLM awal (mis. 0.1–3B parameter) dan siapkan set uji internal.
- Jalankan baseline tanpa tuning; catat metrik dan biaya.
Hari 31–60: Optimasi terukur
- Lakukan LoRA/QLoRA pada data terkurasi; iterasi cepat dengan early stopping.
- Terapkan kuantisasi int8; uji int4 jika akurasi tetap memenuhi ambang.
- Optimalkan inferensi: batching, streaming, speculative decoding. Bangun dashboard biaya dan latensi.
Hari 61–90: Hardening dan peluncuran terbatas
- Tambahkan filter keamanan, logging terstruktur, dan versioning model.
- Canary release ke 5–10% trafik; bandingkan A/B terhadap baseline.
- Susun SOP incident, rollback plan, dan dokumentasi kepatuhan.
Target akhir: SLM yang memenuhi SLA, menekan biaya, dan mudah dirawat. Setelah stabil, perluas cakupan use case secara bertahap.
Kesimpulan
Small Language Models memberi jalur pragmatis untuk menghadirkan AI yang cepat, hemat, dan cukup andal di dunia nyata. Dengan kombinasi distilasi, kuantisasi, dan LoRA yang dipantau ketat lewat metrik relevan, Anda bisa memindahkan mayoritas beban kerja ke model ringkas—tanpa mengorbankan pengalaman pengguna maupun kepatuhan. Mulailah kecil, ukur agresif, lalu skalakan dengan percaya diri.