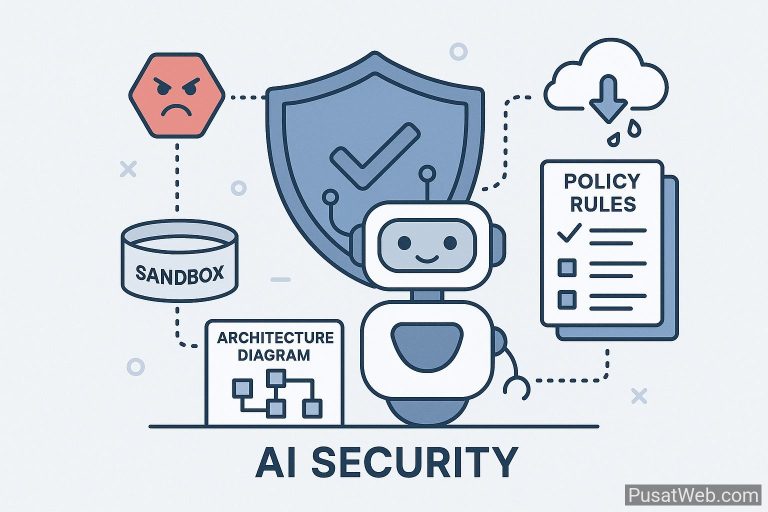
Keamanan AI: Menghadapi Prompt Injection & Kebocoran Data
Panduan keamanan AI menghadapi prompt injection dan kebocoran data: teknik deteksi, guardrails, sandboxing, serta praktik terbaik untuk sistem generatif.
Panduan keamanan AI menghadapi prompt injection dan kebocoran data: teknik deteksi, guardrails, sandboxing, serta praktik terbaik untuk sistem generatif.
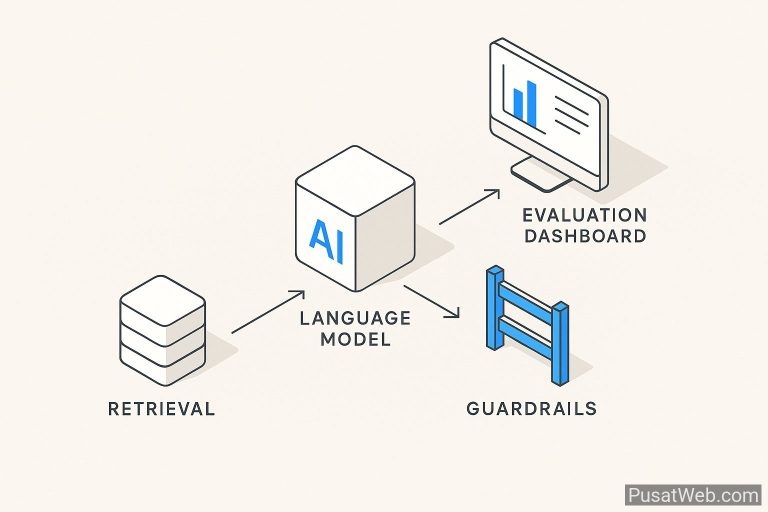
Panduan praktis mitigasi halusinasi LLM: RAG yang efektif, guardrails kebijakan, dan evaluasi ketat untuk jawaban akurat, aman, terukur di produk Anda.
Panduan praktis observabilitas AI untuk model generatif: metrik kunci, arsitektur monitoring, evaluasi, RCA, agar kualitas, biaya, dan risiko tetap terkendali.