Satu baris teks berbahaya bisa mengacaukan keputusan model generatif. Itulah sebabnya keamanan AI bukan lagi “opsional”, tapi fondasi produk yang melibatkan model bahasa besar, agen, dan orkestrasi tool. Tanpa proteksi yang tepat, serangan prompt injection dan kebocoran data dapat merusak reputasi, melanggar regulasi, dan membocorkan rahasia bisnis.
Mengapa Prompt Injection Berbahaya?
Prompt injection adalah teknik rekayasa input yang memaksa model mengabaikan instruksi awal dan mengikuti perintah penyerang. Dampaknya tak hanya jawaban yang menyimpang, tetapi juga eksekusi aksi berisiko ketika model terhubung ke tool, API, atau basis data internal. Serangan ini makin berbahaya pada skenario agen yang menelusuri web atau membaca dokumen.
Jalur serangan yang umum:
- Direct injection: pengguna menyisipkan instruksi bertentangan untuk mengubah perilaku model.
- Indirect injection: konten eksternal (halaman web, dokumen) berisi “pesan tersembunyi” yang mempengaruhi model saat diringkas atau diambil (RAG).
- Tool hijacking: model diarahkan memanggil tool tertentu untuk mengunduh file, mengeksekusi skrip, atau mengekstrak data sensitif.
- Persuasion/jailbreak: model diajak melanggar kebijakan dengan narasi, permainan peran, atau format aneh yang melewati filter sederhana.
Intinya: serangan tak selalu datang dari pengguna. Sumber data, plugin, dan koneksi eksternal bisa menjadi “pintu samping”.
Pilar Keamanan AI untuk Sistem Generatif
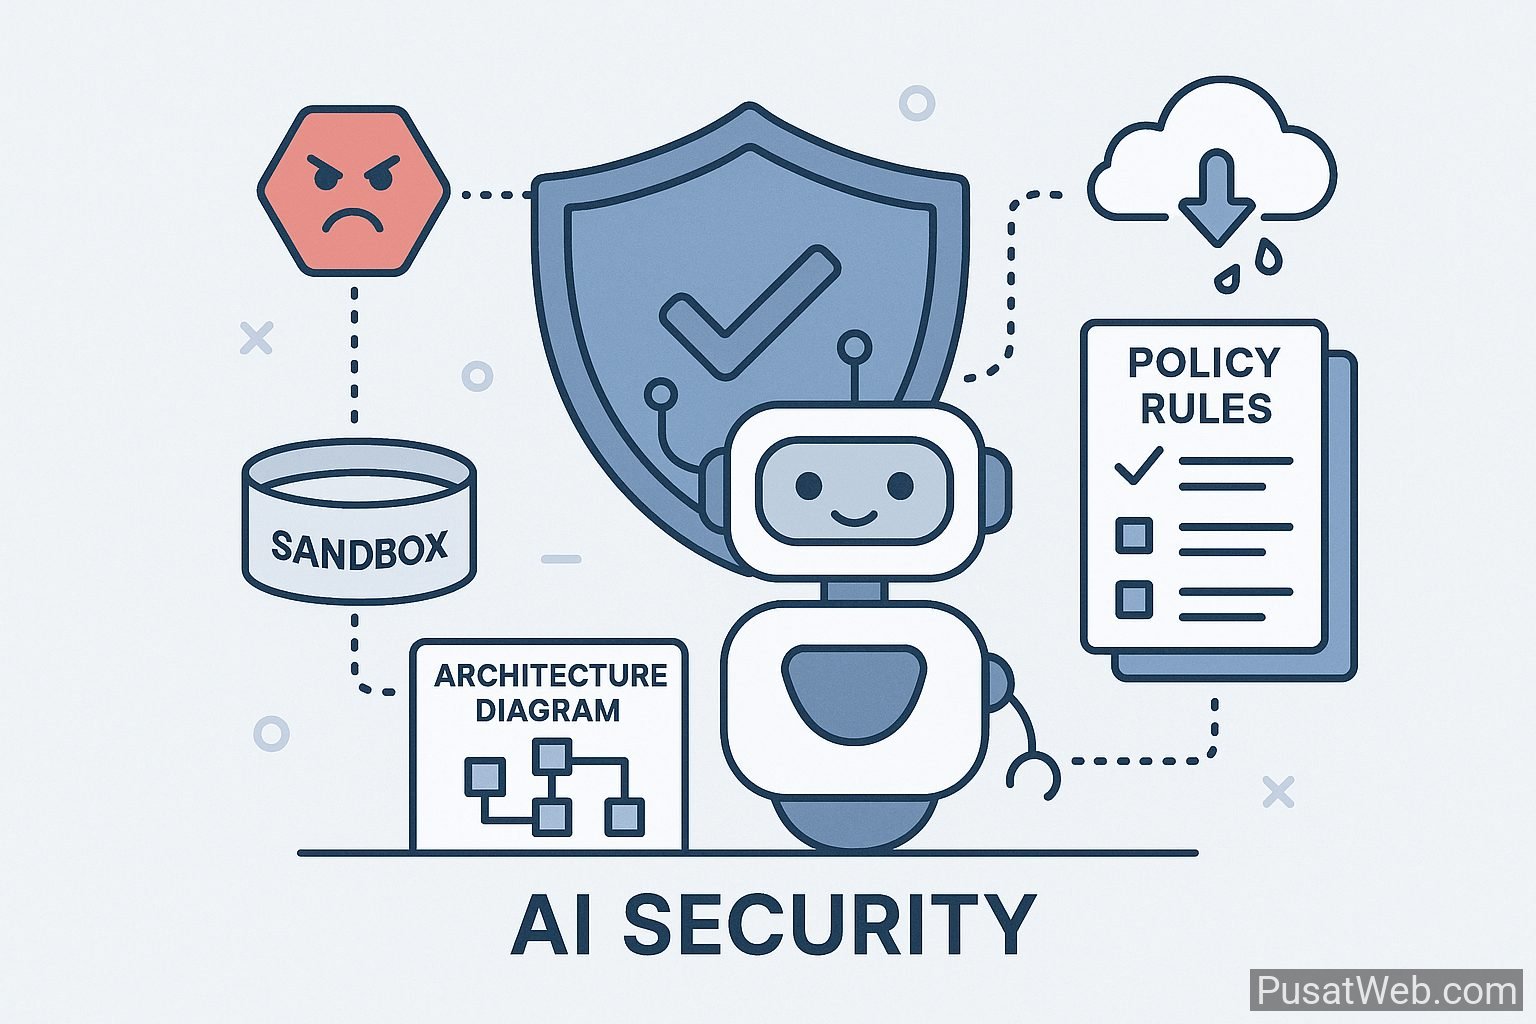
Membangun sistem aman membutuhkan beberapa lapisan kontrol yang saling melengkapi. Anggap ini sebagai arsitektur “zero trust” untuk alur AI, bukan satu filter ajaib. Setiap lapisan menahan kelas risiko yang berbeda.
- Boundary & trust model: bedakan jelas konteks tepercaya (system prompt, kebijakan) dari konteks tidak tepercaya (input user, web, dokumen). Tandai asal-usul (provenance) setiap potongan konteks.
- Least privilege untuk tool: batasi kemampuan agen dengan allowlist API, kuota, scope granular, dan rate limiting. Jangan pernah memberi akses menulis/eksekusi tanpa pengaman.
- Sandbox & egress control: jalankan aksi berisiko di sandbox (isolasi file/network), batasi domain tujuan (egress allowlist), dan gunakan pemindaian malware untuk unduhan.
- Filtering input/output: gabungkan pemeriksaan pola, klasifikasi, dan verifikasi struktur agar model tetap pada format aman (misalnya JSON yang tervalidasi skema).
- Policy engine & governance: definisikan aturan yang dapat diaudit untuk PII/PHI, rahasia bisnis, dan kepatuhan. Integrasikan DLP dan mekanisme redaksi otomatis.
- Observabilitas & audit: catat percakapan, pemanggilan tool, keputusan agen, dan pelanggaran kebijakan untuk forensik dan perbaikan cepat.
Teknik Deteksi dan Mitigasi Prompt Injection
Tak ada satu teknik yang sempurna. Kombinasikan heuristik cepat, verifikasi berbasis model, dan kontrol struktural agar serangan sulit menembus. Fokus pada pencegahan sebelum aksi berisiko terjadi.
1) Deteksi berbasis pola dan konteks
- Heuristik: cari frasa seperti “abaikan instruksi”, “ganti aturan”, atau upaya mengekstrak rahasia. Gunakan daftar indikator yang diperbarui dari temuan red team.
- Segmentasi konteks: pisahkan instruksi sistem dari data tak tepercaya. Hindari mencampur perintah kebijakan dengan isi dokumen.
- Origin tag: sertakan metadata asal setiap konteks sehingga modul deteksi bisa menerapkan kebijakan berbeda untuk sumber berbeda.
2) Hardening prompt dan kontrol eksekusi
- Instruksi defensif: tegaskan prioritas kebijakan, larangan mengeksekusi perintah dari data tak tepercaya, dan keharusan konfirmasi untuk aksi berisiko.
- Function calling terikat skema: paksa output ke format ketat, validasi skema, dan cek type sebelum memicu tool apa pun.
- Gating sebelum tool: lakukan safety check terpisah (bisa LLM kedua) sebelum mengizinkan panggilan API, unduhan, atau pembuatan file.
3) Validasi output dan guardrails decoding
- Validator berlapis: setelah model menjawab, jalankan pemeriksaan kebijakan (PII, kebencian, kebohongan berbahaya) dan format.
- Constrained decoding: gunakan kosakata terbatas atau regex-guided decoding untuk respons terstruktur.
- Self-consistency & cross-check: minta model memeriksa kembali kepatuhan kebijakan atau gunakan model pendamping untuk consensus.
Melindungi Data: Dari Prompt Leaks hingga Exfiltration
Kebocoran tak selalu eksplisit. Model bisa “terpancing” mengungkapkan rahasia konfigurasi, kunci API, atau potongan data pelatihan. Lindungi pipa data dari hulu ke hilir.
- Secret & PII redaction: lakukan pemindaian dan penyamaran sensitif sebelum data masuk ke konteks maupun keluar sebagai jawaban.
- DLP inference-time: terapkan pemeriksaan kebijakan pada setiap token keluaran yang berpotensi mengandung informasi rahasia.
- RAG yang aman: gunakan index terpisah per level akses, allowlist sumber, dan document-level ACL untuk mencegah pengambilan lintas tenant.
- Kontrol akses & tokenisasi: enkripsi penyimpanan, rotasi kunci, dan batasi scope token API; log semua akses untuk audit.
- Egress policy: blok kirim data ke domain tak dikenal, verifikasi ukuran/konten unggahan, dan siapkan kebijakan pemblokiran otomatis saat anomali muncul.
Tip: pisahkan rahasia dari konteks model. Jika perlu, gunakan just-in-time credentials yang kedaluwarsa cepat.
Operasional: Uji, Pantau, dan Tanggap Insiden
Keamanan AI bukan fitur sekali jadi. Perlakukan sebagai siklus hidup: uji terus, pantau ketat, dan tanggapi cepat setiap insiden. Proses yang matang sering lebih berdampak daripada model yang paling canggih sekalipun.
- Red teaming berkelanjutan: buat katalog skenario serangan (direct/indirect injection, jailbreak, data exfiltration), otomatisasi pengujian, dan ukur tingkat lolos.
- Runbook insiden: siapkan prosedur rollback, pemutusan tool, rotasi kunci, pemberitahuan pengguna, serta langkah forensik.
- Metrik dan alert: pantau rasio gagal validasi, panggilan tool diblokir, pola permintaan mencurigakan, serta anomali asal konteks.
- Pelatihan tim & governance: pastikan developer, keamanan, dan kepatuhan berbagi bahasa yang sama: kebijakan, peran, dan tanggung jawab jelas.
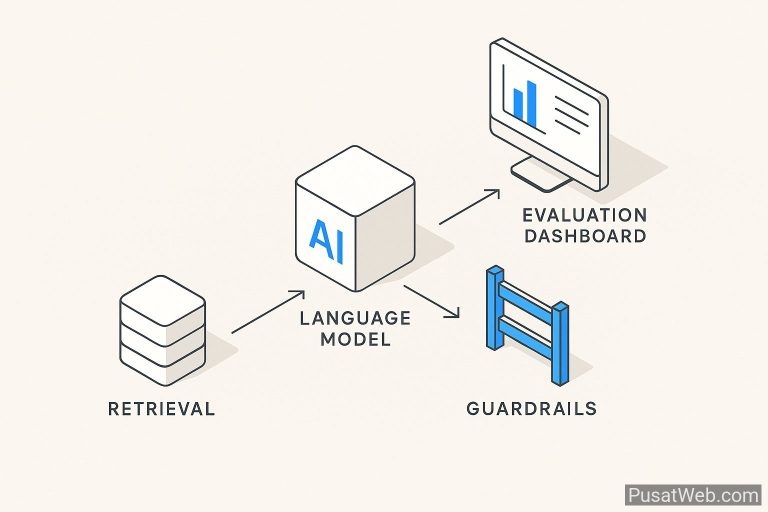
Terakhir, evaluasi trade-off: beberapa guardrail menambah latensi atau biaya. Gunakan pendekatan bertingkat—cepat di tepi (heuristik), lebih dalam saat berisiko (LLM-judge), dan sangat ketat sebelum eksekusi tool.
Kesimpulan: Keunggulan AI modern datang dengan risiko baru. Dengan mendesain arsitektur berlapis—dari pemisahan konteks, sandboxing, validasi terstruktur, hingga DLP inferensi—Anda dapat menurunkan peluang prompt injection dan kebocoran data secara signifikan. Keamanan AI yang efektif adalah kombinasi teknik, proses, dan disiplin operasional—dibangun sejak awal, diuji terus-menerus, dan diaudit tanpa kompromi.